



 人民網+
 中國共產黨新聞網
 領導留言板
 強國論壇
 人民視頻
當數據開始“閉環”,AI的下一站去向何方?
——WAIC 2026語料創新論壇觀察
 訂閱已訂閱已收藏
 收藏
 小字號
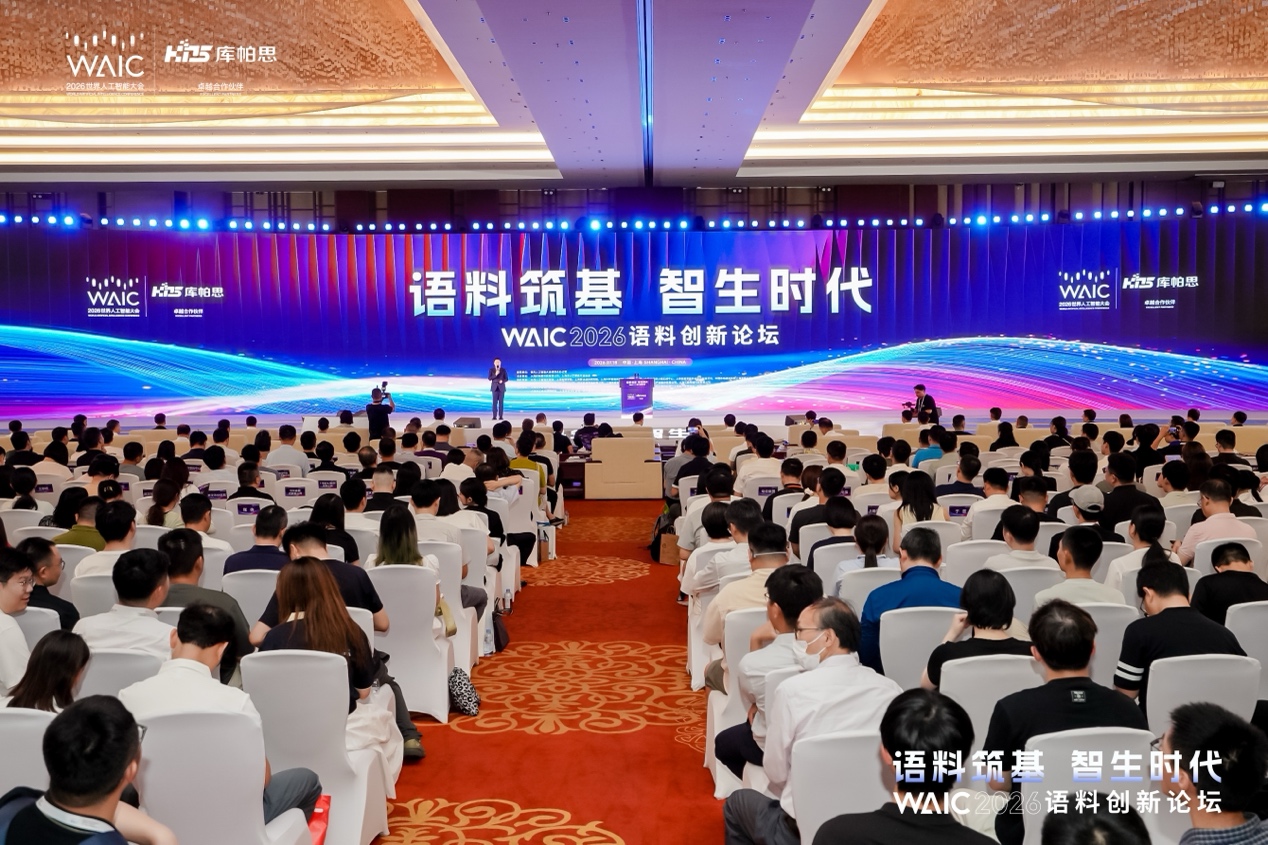
WAIC 2026語料創新論壇現場
7月18日,上海世博中心金廳,一場名為“語料筑基、智生時代”的語料創新論壇,與算力基建論壇、大模型底層供應鏈論壇共同勾勒出2026年AI產業的完整發展主線。
三年前,行業還在為“參數競賽”爭得頭破血流﹔一年前,人們開始意識到“數據質量決定模型上限”。而今天,這個論壇釋放出一個更清晰的信號:AI產業的競爭,正在從“卷參數、卷算力”轉向“卷數據、卷閉環”。
范式之變:從“一次性交付”到“數據在閉環”
國家數據局局長劉烈宏在致辭中給出了一組令人印象深刻的數據:截至2026年6月底,全國已建成高質量數據集12萬個,總體量超過1565PB,較一季度末增長超60%,這相當於中國國家圖書館數字資源總量的547倍。
還值得關注的是,7個數據標注先行先試城市標注規模超119PB,帶動相關產業產值263億元。
數字震撼,但真正的看點不在規模,而是邏輯轉變。本屆論壇上最核心的發布——語料運營公共服務平台2.0提出了一個關鍵詞:“數據在閉環”。

語料運營公共服務平台2.0發布
從“如何更好地組織數據”到“如何更好地提煉數據”,從“數據的一次性交付”到“打造數據在閉環”,平台2.0首創“篩選—轉換—合成”三層十級數據進化路線,並集成語料FDE工程平台、老師傅語料工程化平台和“語匠”專家眾包網絡。這標志著語料建設從靜態的資源堆砌,走向動態的能力運營。
什麼是“閉環”?
上海人工智能實驗室領軍科學家喬宇在演講中給出了一個形象的解釋:在過去,模型預訓練是單向過程,即收集人類數據、讓模型學習﹔但高質量數據越來越稀缺的今天,這種模式的邊際效應正在遞減。面向未來,數據和模型必須共生演化:通過更強的模型構造更優的數據,通過更優的數據推進更強的模型。
上海信投副總裁、庫帕思董事長山棟明則把這一邏輯推進到企業的日常運營層面:“不是每年做一次大盤點,而是通過質量檢測、問題定位、工藝改進,成為日常的循環。”
他提出了AI原生的“五步法”,其中特別強調“六四分”和“學生思維”——“首先出來的事兒就是60分,只要用上飛輪迭代就會形成從初中生到高中生再到大學生”的蛻變。
與此同時,論壇集中發布了面向醫療、工業、交通、供應鏈、城市治理等真實場景的系列語料數據創新產品:專病語料庫、焊接老師傅語料庫、城市軌道交通行業語料庫、港口堆場老師傅經驗語料庫……這些產品的一個共同特征是頗為有趣:它們不再是靜態的“數據包”,而是嵌入真實業務流程、可訓練、可推理、可調用、可評測的語料能力。
“數據在閉環”的另一個標志是標准體系的完善。
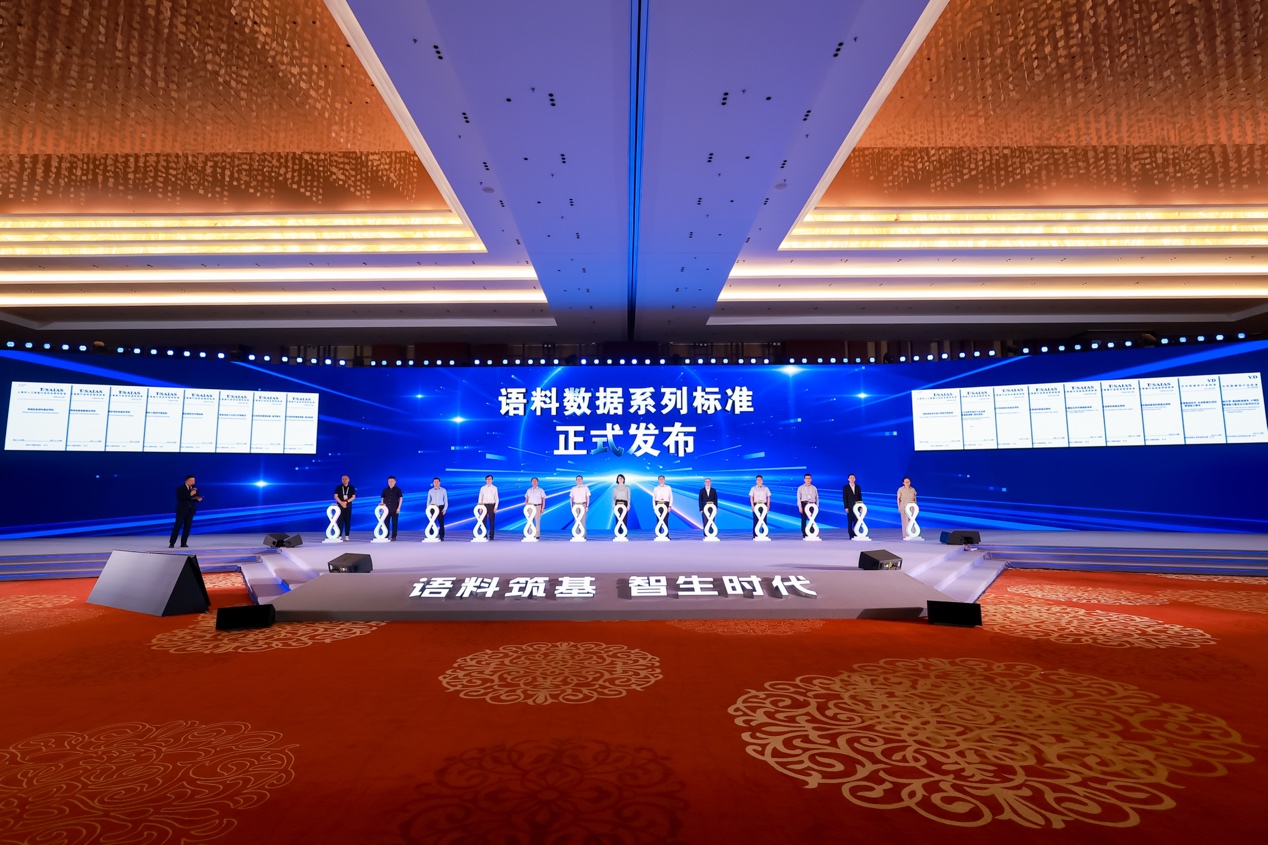
語料數據系列標准發布
在去年發布10項團體標准的基礎上,今年論壇新增發布15項團體標准和2項行業標准,覆蓋高端裝備、消防、醫療專病、藝術人才培養、國際物流供應鏈等方向。標准的意義在於讓“好數據”有了可操作的標尺,讓閉環有了可復制的路徑。
數據驅動:從“學知識”到“學做任務”
“數據決定上限”——這是本屆論壇上多位嘉賓反復強調的一個核心判斷。
人民日報社傳播內容認知全國重點實驗室(人民網)負責人表示,人民日報社將建設“AI友好型”主流價值服務平台,發揮好“主流價值語料庫”功能,為人工智能發展筑牢價值觀底座。“AI友好型”主流價值服務平台將構建一套面向大模型、智能體、數字人的全新技術標准、數據標准、服務標准,助力人工智能更快、更准、更高效地讀取媒體有效信息,進而原生適配A2A(智能體交互)新型業務形態。
復旦大學黨委常委、副校長姜育剛從數字空間到物理世界的視角,剖析了具身智能對數據的全新要求。他指出,當AI從大語言模型走向具身智能,數據需求發生了質變——從互聯網上可公開獲取的數據,轉向物理交互數據、真機操作數據、觸覺和力覺反饋數據。
“機器本身沒有物理交互的數據,就沒有辦法訓練好的具身模型。”他提出具身智能需要三層數據協同:頂層是真機操作數據,中層是結構化的人類施教數據,底層是互聯網仿真和合成數據。
他強調:“失敗的數據”同樣重要——“不能每次訓練的數據都是採集成功的,這些失敗的數據對於模型后面調整、提升模型能力同樣重要。”
上海人工智能實驗室領軍科學家喬宇進一步將這一邏輯上升為“數據定智能——AGI演進的第一性原理”。他提出,從數據到智能有三條轉化法則:
一是智能的廣度取決於數據的規模與多樣性,MinerU工具已在GitHub獲得七萬星標,成為全球影響力最大的智能文檔解析引擎之一﹔
二是智能的深度取決於思維過程數據,論文隻發表正面結果、教科書隻保留最優推導路徑,但真正的智能提升恰恰來自試錯、矛盾與重新思考﹔
三是智能的未來在於數據為核心的自演化。他提出了“數據進化達爾文主義”,數據不是一次性加工的原料,而是持續演化的對象。
山棟明則從產業視角給出了一個判斷:“今天國家的模型全部開源,接下來應用落地的難點已經不在算法本身,在於我們有沒有把數據准備好。”他提出,數據正在從Data for BI向Data for AI轉變:“BI時代的數據是猴子,AI時代的數據是人”,最大的差別在於:BI要的是結果,AI要的是過程。
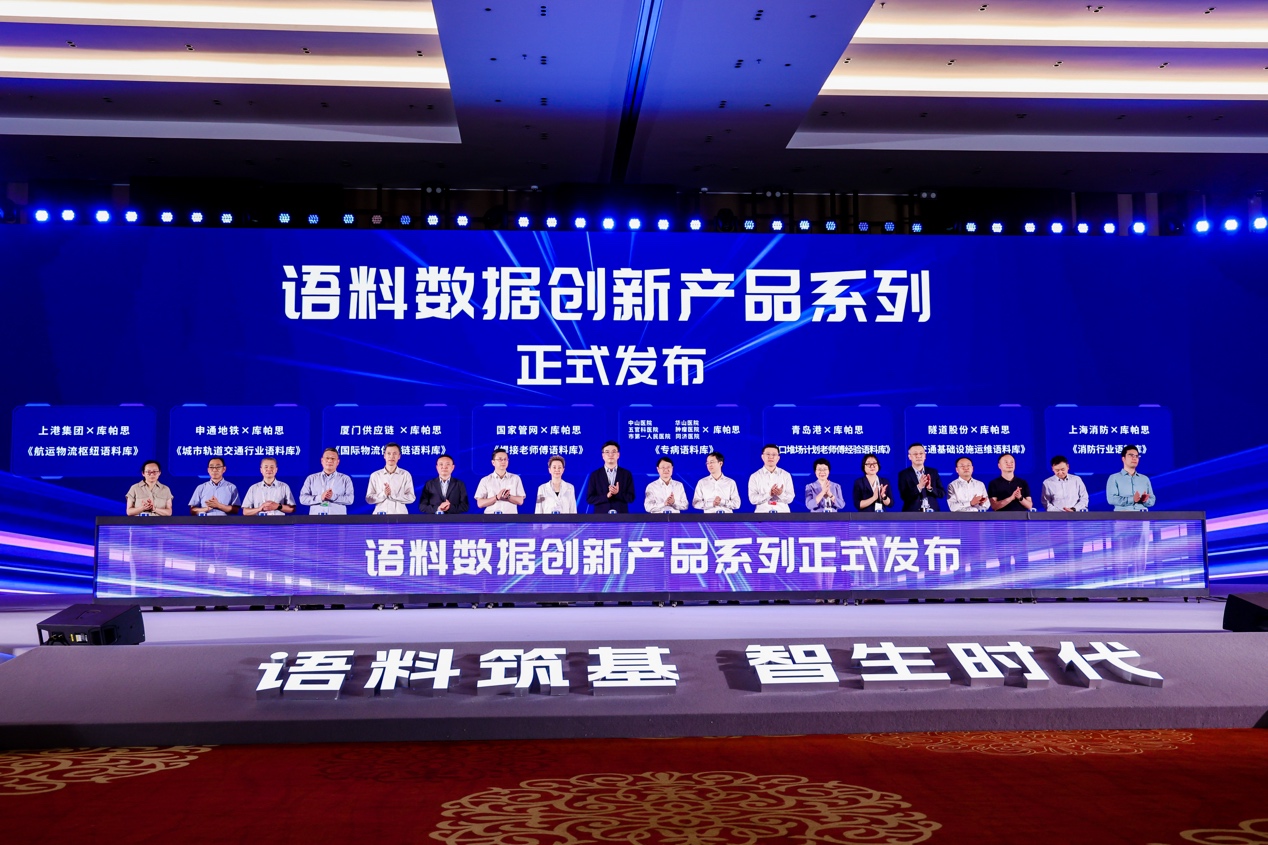
語料數據創新系列產品發布
產業落地:語料如何才能“落地生根”
理論的清晰不等於落地的順暢。論壇的案例分享環節,四位來自產業一線的嘉賓給出了各自的答案。
山東港口青島港集團黨委委員、常務副總經理吳宇震分享了港口AI的實踐。青島港2025年貨物吞吐量7.4億噸、集裝箱3289萬標箱,穩居全球第四和第五位。2025年5月,青島港獲批國家人工智能應用中試基地,是全國首批、港口行業唯一。
通過“老師傅”經驗語料化的七步法,青島港將堆場計劃這一核心生產環節的經驗轉化為可沉澱、可調用、可傳承的組織資產,使港口整體作業效率提升10%。
上海信投智能科技副總經理陶思遠分享了軌道交通、制造業、新材料等場景的實踐。核心方法論是“知識化+工程封裝”,即先把老師傅做什麼的流程知識化,再把重復性工作封裝成工作流和skills。
邏輯朴素但有效:“不怕開工的時候知識看不到頭,要干活,還是先從小切口做起。”
億歐董事長王彬發布的《從AI語料到商業落地價值洞察分享》報告,給出了一組行業判斷:中國AI解決方案提供商已達7萬家,垂直領域語料積累越深越值錢﹔通用大模型數量隻佔所有大模型的1%,99%的垂類大模型值得開發﹔到2030年智能體市場有望達到500億美金。
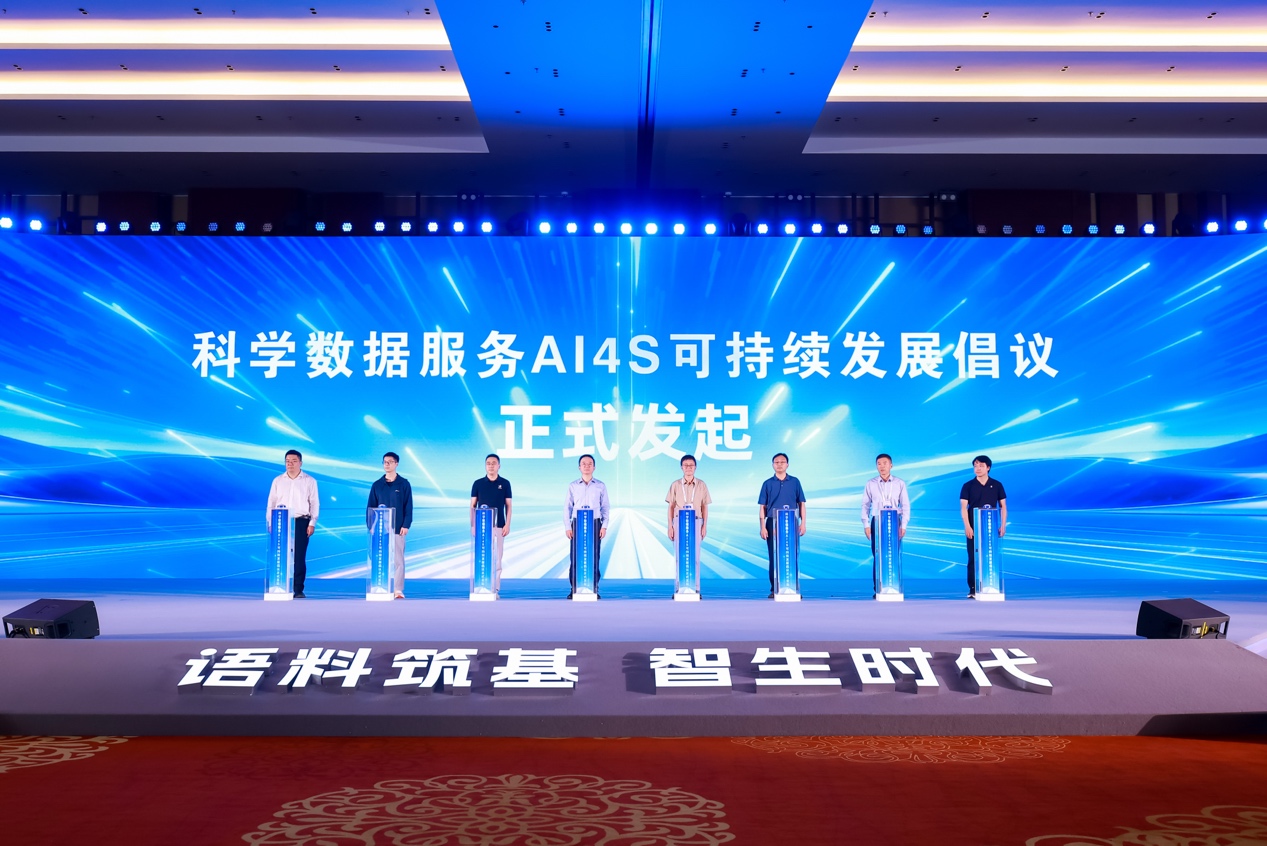
科學數據服務AI4S可持續發展倡議正式發起
圓桌論壇上,四位來自學術界和產業界的嘉賓圍繞“AI4S科學數據的未來”展開討論。上海科學智能研究院AI科學家魏龍分享了一個令人印象深刻的案例:一位律師通過AI軟件參與科學智能比賽,連續六天保持第一名——“文科生做自然科學研究,這意味著新的時代,已經有了。”
從語料運營公共服務平台2.0的發布,到七項系列成果的集中亮相﹔從“數據在閉環”的理念提出,到“老師傅經”的產業實踐……2026年的語料創新論壇,已經不再是關於“數據很重要”的呼吁,而是關於“數據如何變得更好用、如何持續變好”的系統性回答。
正如喬宇在演講中所說:“未來AGI不僅僅是一場規模的競賽,更重要的是我們為智能提供更高密度、更完整流程,包含數字世界和物理世界的全流程數據。”
而山棟明的判斷更加直白:“語料數據的AI Ready,是接下來挑戰我們的堵點、痛點和難點,一旦突破,AI應用落地將會突破它的天花板。”
當數據開始“閉環”,AI的下一站,或許真的不遠了。
(文中圖片均由主辦方提供)
分享讓更多人看到 
 人民日報
 人民網+
 手機人民網
 領導留言板
 人民視頻
 人民智作
人民日報社概況 | 關於人民網 | 報社招聘 | 招聘英才 | 廣告服務 | 合作加盟 | 供稿服務 | 數據服務 | 網站聲明 | 網站律師 | 信息保護 | 聯系我們
人民日報違法和不良信息舉報電話:010-65363263 舉報郵箱:jubao@people.cn
人民網服務郵箱:kf@people.cn 違法和不良信息舉報電話:010-65363636 舉報郵箱:rmwjubao@people.cn
互聯網新聞信息服務許可証10120170001 | 增值電信業務經營許可証B1-20060139 | 廣播電視節目制作經營許可証(廣媒)字第172號
信息網絡傳播視聽節目許可証0104065 | 網絡文化經營許可証 京網文[2020]5494-1075號 | 網絡出版服務許可証(京)字121號 | 京ICP証000006號 | 京公網安備11000002000008號
人 民 網 股 份 有 限 公 司 版 權 所 有 ,未 經 書 面 授 權 禁 止 使 用
Copyright © 1997-2026 by www.people.com.cn. all rights reserved

-
評論

-
關注
微信微博快手
 第一時間為您推送權威資訊
 報道全球 傳播中國
 關注人民網,傳播正能量
